În 2009 îmi finalizam studiile de doctorat cu tema Particularități ale proiectării sistemelor informaționale financiar contabile în medii distribuite. Am învățat, cercetat și experimentat în perioada studiilor diferite platforme de colectare, prelucrare și stocare a datelor și informațiilor, culminând cu participarea pe mai mulți ani la competiția Imagine Cup organizată de Microsoft, dedicată acestor tipuri de implementări. Am înțeles cât de importantă este partea de proiectare și testare și lecția supremă: nu contează cât de mult ai încercat, ci rezultatul să fie funcțional.
De fiecare dată când la nivel național s-a lansat câte o platformă pentru ceva anume, aproape întotdeauna a fost cu probleme de subdimensionare în momentul în care s-a făcut trecerea în “producție”. Amintim doar: Cardul Național de Sănătate și sistemul SIUI (CNAS), Platforma IMM Invest, Portalul RO Vaccinare, Sistemele RO e-Factura și SPV și altele. Majoritatea problemelor au apărut din cauza proiectării. Întâmplător sau nu, am lucrat o singură dată pentru organismele statului pentru proiectarea și implementarea unui sistem informatic, dar era doar pentru intern. Această experiență în schimb m-a făcut să înțeleg cum se lucrează și de ce multe din astfel de proiecte eșuează. Dar de fapt ”strategia” este puțin altfel: digitalizarea este o afacere foarte bănoasă (pentru anumite companii), mai ales dacă ea este continuă…
În continuarea acestui articol voi încerca să explic din punct de vedere tehnic ce s-a întâmplat cu eșecul lansării TollRo din 1 octombrie 2026 pentru că oferă un studiu de caz interesant despre diferența dintre dezvoltarea unei aplicații informatice și operarea unui serviciu digital critic la scară națională. Încă de la început doresc să menționez că nu dețin foarte multe detalii despre probleme, în afara celor care au apărut în presă și articolul acesta încearcă o tentă educativă.
Pe scurt, pentru cei care nu sunt la curent cu problema, în primele ore de funcționare au apărut probleme de acces, întârzieri în transmiterea mesajelor electronice și dificultăți în anumite fluxuri de plată. CNAIR a explicat că platforma s-a confruntat cu un volum foarte mare de utilizatori și tranzacții imediat după lansare, iar ulterior a anunțat măsuri de creștere a capacității și de stabilizare a serviciului. În primele 12 ore, conform datelor publicate de companie, platforma fusese accesată de aproximativ patru milioane de vizitatori și utilizatori autentificați, fuseseră înregistrați circa 50.000 de utilizatori și 170.000 de vehicule, emise peste 45.000 de tichete de rută și procesate peste 60.000 de plăți.
Aceste cifre explică amploarea lansării, dar nu sunt suficiente pentru a identifica precis cauza tehnică a incidentelor. Din exterior nu avem acces la arhitectura platformei, la loguri, la metricile infrastructurii, la rezultatele testelor de performanță sau la configurația componentelor software. De aceea, ar fi excesiv să afirmăm că TollRo a suferit, în mod demonstrat, de o „arhitectură software greșită”.
Putem însă face ceva mai util: să pornim de la ceea ce este documentat public și să explicăm ce presupune, în ingineria software modernă, pregătirea unui asemenea sistem pentru producție.
Un sistem poate funcționa și totuși să nu fie pregătit pentru producție
Una dintre confuziile frecvente în proiectele informatice este echivalarea funcționării aplicației cu pregătirea ei pentru exploatare reală. Dacă un utilizator poate crea un cont, poate înregistra un vehicul și poate realiza o plată, putem spune că fluxul respectiv funcționează. Acest lucru demonstrează însă în primul rând corectitudinea funcțională.
În producție apare o întrebare diferită: ce se întâmplă atunci când mii sau zeci de mii de persoane încearcă să execute aceleași operații într-un interval foarte scurt?
Aici intrăm în zona numită production readiness (pregătirea pentru producție). Ea nu privește doar corectitudinea codului, ci capacitatea, performanța, monitorizarea, recuperarea după erori, dependențele externe, securitatea și comportamentul sistemului atunci când una dintre componente începe să funcționeze lent sau devine temporar indisponibilă.
Checklist-ul clasic folosit de companiile mari de software și cloud pentru lansarea serviciilor include tocmai asemenea întrebări: care este traficul estimat, cât de mare poate fi vârful din momentul lansării, care este combinația diferitelor tipuri de solicitări, ce arată un test end-to-end, cum se comportă serviciile externe, ce timeout-uri și retry-uri există și cum se degradează serviciul dacă o dependență nu mai funcționează.
Această distincție este importantă pentru a înțelege cazul TollRo. Nu discutăm doar despre întrebarea „funcționa aplicația?”, ci despre una mai complexă: era întregul ecosistem pregătit pentru comportamentul real al utilizatorilor din momentul lansării?
Ce înseamnă, de fapt, „foarte mulți utilizatori”?
Cifra de aproximativ patru milioane de accesări în primele 12 ore este impresionantă, dar, din punct de vedere tehnic, nu ne spune singură cât de solicitat a fost sistemul.
Pentru analiza capacității sunt mai importante alte valori: câte cereri erau procesate într-o secundă, câți utilizatori erau activi simultan, câte operații genera fiecare acțiune din interfață, cât dura răspunsul bazei de date și cât timp era consumat în apelurile către sistemele externe.
În terminologia tehnică apar aici câteva metrici importante. RPS (requests per second) arată câte solicitări primește sistemul într-o secundă. Concurrency descrie câte operații sunt procesate simultan. Latency măsoară timpul necesar pentru răspuns, iar valori precum p95 sau p99 încearcă să surprindă experiența utilizatorilor mai puțin norocoși: de exemplu, p99 indică timpul sub care sunt finalizate 99% dintre solicitări. Mai există apoi saturation, adică momentul în care o resursă începe să ajungă la limita sa: procesoare, memorie, conexiuni la baza de date, thread-uri, lățime de bandă sau capacitatea unui serviciu extern. Aceste valori sunt importante deoarece patru milioane de accesări distribuite relativ uniform pe parcursul unei zile reprezintă un fenomen complet diferit de câteva sute de mii de operații concentrate într-un interval foarte scurt.
AWS, de exemplu, recomandă tocmai de aceea ca testarea de încărcare să fie făcută asupra întregului workload, într-un mediu comparabil cu producția și inclusiv la valori mai mari decât traficul estimat. Testarea doar a componentelor individuale sau numai până la încărcarea așteptată este considerată o practică insuficientă, deoarece nu arată locul în care sistemul va începe să se degradeze.
Lansarea TollRo avea și un profil particular de trafic
În cazul TollRo există un detaliu foarte important pentru această discuție. Cu doar câteva ore înaintea trecerii la versiunea de producție, CNAIR a anunțat că datele din aplicația pilot nu vor fi migrate. Operatorii care participaseră la pilotare trebuiau să își creeze din nou conturile, să reintroducă datele companiilor și să înregistreze din nou vehiculele și remorcile. Din punct de vedere tehnic, acest lucru înseamnă că lansarea nu genera doar trafic normal de utilizare. Genera simultan un volum important de bootstrap traffic: operațiile necesare pentru inițializarea unei baze mari de utilizatori. Crearea unui cont este de obicei mai costisitoare decât simpla autentificare într-un cont existent. Poate implica scrieri în baze de date, validări, generarea unor token-uri, apeluri către alte sisteme, transmiterea unor mesaje de confirmare și înregistrarea altor informații asociate. Același lucru se întâmplă la introducerea unei flote de vehicule. În consecință, profilul de trafic din prima zi poate fi foarte diferit de cel care va exista peste o lună, când majoritatea utilizatorilor au deja conturile și vehiculele înregistrate.
Google SRE (Site Reliability Engineering – o disciplină de inginerie software creată de Google pentru a gestiona, automatiza și menține scalabilitatea, disponibilitatea și securitatea sistemelor IT de mare anvergură) atrage atenția exact asupra acestui fenomen: un launch spike nu înseamnă neapărat doar mai mult trafic, ci poate însemna și un traffic mix diferit de cel întâlnit în funcționarea normală. În unele lansări documentate de Google, vârfurile au depășit de câteva ori estimările inițiale.
Prin urmare, una dintre întrebările relevante pentru orice sistem de acest tip ar fi: a fost testată înainte de lansare nu doar cantitatea de trafic, ci exact combinația de operații care urma să apară în primele ore?
Load testing, stress testing și diferența dintre ele
Aici merită lămuriți doi termeni utilizați frecvent:
- Load testing înseamnă testarea comportamentului aplicației la un nivel realist de încărcare. Dacă estimăm, de exemplu, că într-o oră vor exista 20.000 de utilizatori activi, încercăm să reproducem un asemenea scenariu înainte de lansare și urmărim timpii de răspuns, rata erorilor și consumul resurselor.
- Stress testing merge mai departe. Creștem intenționat încărcarea peste valorile anticipate pentru a identifica limita sistemului și, mai ales, pentru a observa cum se comportă atunci când ajunge acolo.
Această diferență este importantă. Nu este realist să presupunem că orice sistem poate suporta orice volum de trafic. Resursele sunt finite chiar și într-un cloud privat. Ceea ce ne dorim însă de la un sistem bine proiectat este ca depășirea capacității să nu producă un colaps necontrolat. La 110% din capacitatea proiectată, poate răspunde mai lent. La 150%, poate limita temporar unele operații. La 200%, poate refuza controlat anumite solicitări și îi poate informa pe utilizatori că serviciul este temporar aglomerat.
Acest comportament poartă numele de graceful degradation, degradare controlată. Sistemul nu încearcă să mențină toate funcțiile cu orice preț, ci protejează operațiile esențiale și încearcă să evite propagarea unei probleme către întregul serviciu.
TollRo nu este o aplicație izolată
O altă parte importantă a incidentului privește serviciile externe. CNAIR a anunțat probleme în interconectarea cu procesatorul de plăți, mai exact în fluxurile de autorizare și confirmare a tranzacțiilor. De asemenea, compania a descris ulterior procesul de verificare și reconciliere a plăților efectuate în intervalul afectat. Acest lucru ne amintește de o caracteristică esențială a aplicațiilor moderne: ele sunt rareori sisteme complet independente.
Un flux poate arăta, simplificat, astfel:
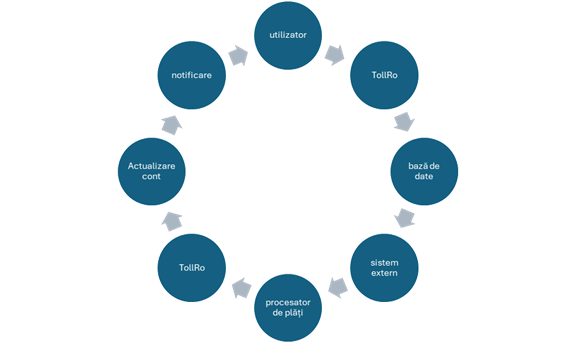
Pentru utilizator toate acestea reprezintă „TollRo”. Din punct de vedere tehnic însă, sunt mai multe servicii, posibil operate de organizații diferite și conectate prin rețea. Aici apare noțiunea de dependency (dependență): un sistem poate fi perfect funcțional în interior și totuși să ofere o experiență slabă dacă un serviciu extern începe să răspundă lent.
Să presupunem că un serviciu răspunde în mod normal în 200 de milisecunde, dar ajunge temporar la zece secunde. Aplicația care îl apelează poate rămâne cu conexiunile ocupate, utilizatorul poate apăsa din nou butonul, iar alte componente pot începe să acumuleze cereri. Problema inițială poate astfel să se propage.
De ce retry-ul nu este întotdeauna soluția
În asemenea situații, primul instinct al programatorului este adesea rezonabil: dacă apelul nu a reușit, îl încercăm din nou, operațiunea fiind cunoscută sub numele de retry. Pentru o eroare tranzitorie poate fi o soluție foarte bună. Dacă o conexiune de rețea a avut o problemă timp de câteva sute de milisecunde, următoarea încercare poate reuși. Dar retry-urile trebuie controlate și condiționate. Să presupunem că un serviciu poate procesa 1.000 de solicitări pe secundă, dar primește 2.000. Unele solicitări vor eșua. Dacă fiecare dintre ele este retrimisă imediat de două sau trei ori, serviciul deja suprasolicitat poate primi 4.000 sau 5.000 de solicitări și astfel problema se amplifică singură, dintr-un comportament, am spune, normal al utilizatorilor în condiții de stres.
În literatura de specialitate fenomenul este cunoscut ca retry storm și poate contribui la un cascading failure. Microsoft recomandă, printre altele, un număr finit de retry-uri, întârzieri progresive între încercări și chiar bugete globale de retry, tocmai pentru ca un număr mare de clienți să nu suprasolicite colectiv o dependență care încearcă să se recupereze.
O tehnică frecvent utilizată este exponential backoff: dacă prima încercare eșuează, aștepți puțin; dacă și următoarea eșuează, aștepți mai mult, apoi și mai mult. Adesea se adaugă o variație aleatorie (jitter) pentru a preveni reîncercările simultane din partea a mii de utilizatori.
Circuit breaker: când este mai sănătos să nu mai încerci
Pentru probleme care persistă există un alt mecanism, numit circuit breaker, al cărui nume vine chiar de la siguranța electrică. Dacă un serviciu extern începe să producă multe erori, aplicația poate decide temporar să nu îl mai apeleze. „Circuitul” intră în starea open, iar solicitările eșuează rapid sau primesc un răspuns alternativ. După o perioadă, sistemul permite câteva solicitări de probă. Dacă ele reușesc, circuitul se închide și traficul normal poate reveni treptat. Scopul nu este doar protejarea aplicației principale, ci și a serviciului care are probleme. Un sistem aflat în recuperare nu este ajutat dacă primește imediat toate solicitările acumulate.
Microsoft descrie circuit breaker-ul tocmai ca pe un mecanism care limitează apelurile repetate către o resursă care probabil va continua să eșueze și ajută la prevenirea propagării incidentului către alte componente. Nu știm dacă TollRo utilizează sau nu acest pattern și incidentul nu permite să tragem o asemenea concluzie. Cazul explică însă foarte bine de ce aceste mecanisme sunt importante atunci când o platformă depinde de servicii pe care nu le controlează complet.
De ce e-mailul este o componentă tehnică, nu doar o notificare
Una dintre problemele documentate pe 1 octombrie a fost transmiterea mesajelor către Gmail și Yahoo. CNAIR a explicat că platforma a generat într-un interval foarte scurt un volum mare de mesaje tranzacționale, iar unele au fost temporar limitate de mecanismele automate ale furnizorilor de e-mail. Acest comportament al furnizorilor nu este neobișnuit. Google recomandă explicit expeditorilor care trimit volume mari de e-mail să crească progresiv volumul, să evite trimiterea în rafale și să monitorizeze reputația domeniului și răspunsurile serverelor. O creștere bruscă a volumului poate duce la rate limiting și amânarea livrării.
Aici apare termenul throttling: în loc să accepte un număr nelimitat de solicitări, un serviciu impune temporar o limită. Nu înseamnă neapărat că mesajele sunt considerate spam; poate însemna pur și simplu că sistemul receptor reduce rata cu care acceptă trafic de la un anumit expeditor.
Pentru un sistem precum TollRo este important ca trimiterea unui e-mail să nu blocheze inutil întreaga tranzacție principală.
O arhitectură uzuală ar putea separa cele două procese:
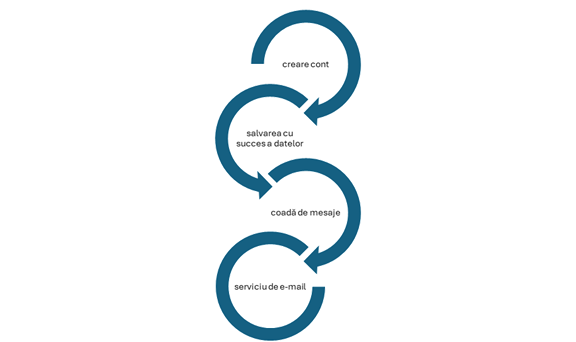
În acest scenariu, dacă furnizorul de e-mail acceptă mesajele mai lent, notificările se acumulează într-o coadă și sunt livrate progresiv. Aplicația principală nu trebuie neapărat să aștepte finalizarea trimiterii fiecărui mesaj. Aceasta este una dintre utilizările procesării asincrone: operațiile care nu trebuie finalizate exact în aceeași fracțiune de secundă sunt decuplate pentru a reduce dependențele și pentru a absorbi vârfurile de trafic.
Plățile aduc o problemă specială: ce faci când nu știi dacă tranzacția s-a executat?
Plățile sunt mai delicate decât multe alte operații. Să presupunem că aplicația transmite unui procesator cererea de plată. Procesatorul debitează cardul, dar conexiunea cade exact înainte ca răspunsul să ajungă înapoi la TollRo. Din perspectiva aplicației există o ambiguitate: plata a eșuat sau doar confirmarea s-a pierdut? Dacă retrimite pur și simplu aceeași operație, există riscul unei procesări duplicate. Aici intervine conceptul de idempotency.
O operație idempotentă poate fi repetată fără ca efectul să se producă de mai multe ori. În cazul unei plăți, două request-uri reprezentând aceeași tranzacție logică trebuie să poată fi recunoscute ca duplicate și să nu determine două debitări. Microsoft recomandă explicit verificarea caracterului idempotent înainte de retry, tocmai deoarece un request poate fi procesat cu succes chiar dacă răspunsul către client nu mai ajunge.
În aceeași logică apare și reconcilierea tranzacțiilor, procedură menționată de CNAIR după incidentele din prima zi. Reconcilierea compară informațiile din sistemele implicate pentru a determina care tranzacții au fost efectiv procesate și pentru a aduce evidențele într-o stare consistentă. CNAIR chiar le-a recomandat utilizatorilor care plătiseră fără să primească o confirmare să nu repete plata până când nu verifică situația în cont. Este o recomandare care ilustrează foarte bine diferența dintre „request-ul a primit eroare” și „tranzacția financiară nu a avut loc”.
Mai multe servere ajută, dar nu rezolvă automat problema
După incident, capacitatea platformei a fost mărită. Aceasta este o reacție firească atunci când există semne de saturație. Totuși, scalabilitatea unui sistem nu depinde doar de numărul de servere. Imaginați-vă că avem zece servere de aplicație care folosesc aceeași bază de date. Dacă serverele aplicației sunt suprasolicitate, putem adăuga încă zece. Dar dacă adevărata limită este baza de date, noua capacitate de procesare poate însemna pur și simplu că trimitem și mai repede cereri către componenta care era deja saturată.
Situația este similară pentru serviciile externe. Dacă acestea permit un anumit număr de conexiuni simultane, multiplicarea serverelor proprii nu mărește automat și capacitatea partenerului. De aceea, performanța trebuie analizată end-to-end, de la utilizator până la ultima dependență relevantă. Într-un sistem distribuit, capacitatea întregului flux este deseori determinată de componenta cea mai restrictivă.
Back-pressure: sistemul trebuie să știe și să spună „mai încet”
Un alt concept util este back-pressure: dacă o componentă poate procesa 1.000 de operații pe secundă, iar alta îi livrează 5.000, există două posibilități: prima este ca cererile să se acumuleze până când memoria, conexiunile sau thread-urile sunt epuizate; a doua este ca sistemul să reducă controlat rata de intrare. Acest mecanism poate lua forma unor cozi, limite de concurență, rate limiting sau prioritizarea anumitor operații.
În termeni simpli, back-pressure înseamnă că o componentă aflată aproape de limită transmite în amonte mesajul: „pot continua, dar nu cu viteza aceasta”. Microsoft subliniază că vârfurile foarte scurte pot destabiliza inclusiv componentele din aval înainte ca throttling-ul obișnuit să intervină și recomandă mecanisme de control al concurenței către dependențele externe.
Astfel de tehnici sunt importante tocmai pentru a transforma o suprasarcină dintr-o cădere generală într-o perioadă de funcționare mai lentă, dar controlată.
Pilotarea și problema timpului disponibil
În cazul TollRo există și o dimensiune importantă legată de calendar. CNAIR anunța pe 18 septembrie că pilotarea publică fusese începută pe 16 septembrie și că, potrivit contractului, această etapă trebuia să dureze minimum patru săptămâni. Compania preciza totodată că sistemul nu intrase încă în etapa de recepție calitativă, care putea începe numai după finalizarea testării și pilotării. CNAIR ceruse deja amânarea aplicării până la 1 aprilie 2027. TollRo a devenit însă operațional la 1 octombrie.
Această cronologie nu dovedește că durata pilotării este cauza directă a incidentelor din prima zi. Ar fi o concluzie pe care datele publice nu o permit. Ea arată însă că lansarea s-a produs înainte de încheierea perioadei minime de pilotare prevăzute contractual și înainte de etapa de recepție calitativă descrisă de CNAIR.
Din perspectiva managementului tehnic, pilotarea nu este doar o perioadă în care „vedem dacă aplicația merge”. Este momentul în care ipotezele de proiectare întâlnesc pentru prima dată utilizatorii și infrastructura reală. În pilotare pot apărea diferențe neașteptate între telefoane, rețele mobile, moduri de utilizare, profile de trafic, date reale, servicii externe și comportamentul prevăzut în laborator.
Tocmai de aceea este util să existe suficient timp între identificarea unei probleme, remedierea ei, retestare și decizia finală de go-live.
Cum ar arăta, „ca la carte”, pregătirea unei asemenea lansări?
Nu există o singură rețetă universală, iar fără documentația internă nu putem spune ce pași au fost sau nu au fost parcurși în cazul TollRo. Putem însă descrie modelul general utilizat pentru sistemele digitale critice.
Înainte de lansare ar trebui cunoscută capacitatea reală a sistemului prin teste de încărcare end-to-end. Nu doar frontend-ul, ci baza de date, autentificarea, plățile, serviciile externe și sistemele de notificare trebuie testate împreună.
Ar trebui apoi testată încărcarea peste estimarea normală, astfel încât echipa să știe unde se află limita și cum se manifestă degradarea.
Dependențele externe ar trebui evaluate separat: ce se întâmplă dacă un sistem răspunde de zece ori mai lent, dacă returnează erori sau dacă devine complet indisponibil?
Pentru aceste situații se proiectează timeout-uri, retry-uri cu backoff, circuit breakers, cozi, mecanisme de throttling și forme de graceful degradation.
Pentru operațiile financiare trebuie gândite idempotency și reconciliere.
Pentru operațiile care nu trebuie efectuate sincron, precum anumite notificări, pot fi folosite cozi și procesare asincronă.
În plus, este nevoie de observability. Acest termen desemnează capacitatea echipei de a înțelege starea internă a sistemului pornind de la ceea ce acesta raportează: metrici, loguri și distributed traces. În timpul unui incident, echipa ar trebui să poată vedea rapid nu doar că „platforma este lentă”, ci dacă problema provine din CPU, conexiunile bazei de date, o anumită interfață externă, procesatorul de plăți sau acumularea unei cozi.
Ideal, toate acestea sunt însoțite de o lansare progresivă (staged rollout) atunci când natura serviciului permite acest lucru. În loc ca întreaga populație să intre simultan într-o versiune complet nouă, traficul poate fi transferat gradual, monitorizând comportamentul sistemului pe măsură ce volumul crește. Și acest tip de abordare apare în practicile de lansare descrise de Google SRE.
Ce putem spune și ce nu putem spune despre TollRo
Din informațiile publice, putem spune că lansarea din 1 octombrie a întâlnit simultan mai multe tipuri de dificultăți: un volum foarte ridicat de acces și tranzacții, probleme asociate livrării mesajelor electronice și dificultăți în anumite fluxuri de plată și integrare. Putem spune, de asemenea, că după incident CNAIR a crescut capacitatea, a început reconcilierea tranzacțiilor și a continuat procesul de stabilizare. Știm și că pilotarea publică începuse cu aproximativ două săptămâni înainte de data intrării în producție și că perioada contractuală minimă menționată de CNAIR era de patru săptămâni.
Nu știm însă dacă principala limitare a fost baza de date, infrastructura de calcul, configurația rețelei, o anumită integrare, algoritmii aplicației sau o combinație între acestea. Nu știm ce rezultate au avut testele de performanță realizate înainte de lansare. Nu știm capacitatea proiectată și nici capacitatea măsurată a platformei. Nu știm ce mecanisme de autoscaling, circuit breaker, caching, rate limiting sau load shedding sunt implementate.
Aceste informații ar putea apărea doar într-o analiză tehnică detaliată sau într-un post-mortem al incidentului.
Prin urmare, cea mai corectă concluzie nu este că „TollRo a avut o arhitectură greșită”, ci că lansarea a scos la suprafață mai multe probleme tipice ale exploatării sistemelor distribuite la scară: capacitate, vârfuri de trafic, dependențe externe și comportamentul unor fluxuri tranzacționale sub sarcină reală.
Dincolo de TollRo
Poate că aceasta este și partea cea mai utilă a întregului episod. Sistemele informatice moderne nu mai pot fi evaluate doar prin întrebarea „merge aplicația?”.
Un sistem critic trebuie evaluat și prin întrebări precum: ce se întâmplă dacă numărul utilizatorilor este de trei ori mai mare decât estimarea? Ce se întâmplă dacă baza de date încetinește? Ce se întâmplă dacă furnizorul de e-mail introduce throttling? Ce se întâmplă dacă procesatorul de plăți primește operația, dar confirmarea se pierde? Ce se întâmplă dacă un serviciu extern nu răspunde timp de cinci minute? Și, poate cel mai important, ce funcții pot continua să opereze atunci când una dintre componente are probleme?
Aceste întrebări reprezintă trecerea de la simpla dezvoltare software la reliability engineering.
Un sistem bine proiectat nu este unul despre care presupunem că nu va avea niciodată probleme. În sisteme suficient de complexe, problemele sunt inevitabile. Un sistem bine proiectat este unul în care limitele au fost căutate înainte de lansare, modurile de defectare au fost anticipate, iar incidentele unei componente nu se transformă automat în indisponibilitatea întregului serviciu.
Din această perspectivă, TollRo poate deveni un studiu de caz foarte util. Nu pentru a identifica de la distanță un vinovat sau un anumit defect de cod, ci pentru a înțelege cât de multă inginerie există între momentul în care o aplicație „funcționează” și momentul în care putem spune că un serviciu digital critic este cu adevărat pregătit pentru producție.
La final câteva detalii financiare și tehnice
1. Costul proiectului și finanțarea
- Valoarea contractului principal (Lot 1): 224,5 milioane de lei (fără TVA) (aproximativ 267 milioane lei cu TVA).
- Sursa de finanțare: Fonduri europene nerambursabile prin PNRR (Planul Național de Redresare și Reziliență), Componenta 10 / Reforme în sectorul transporturilor.
- Durata contractului: Perioadă de dezvoltare/implementare (de circa 10-12 luni), urmată de servicii de mentenanță și suport tehnic pe o perioadă de 5 ani.
2. Actorii principali
- Beneficiarul & Administratorul sistemului: C.N.A.I.R. S.A. (Compania Națională de Administrare a Infrastructurii Rutiere) – entitatea publică responsabilă de colectarea taxelor și gestionarea rețelei de drumuri.
- Dezvoltatorul / Prestatorul IT principal: Vodafone România S.A. – compania desemnată câștigătoare a licitației publice pentru Lotul 1 („Sistem informatic centralizat”).
- Interoperabilitate europeană: Furnizorii SETRE / EETS (European Electronic Toll Service) – operatori terți autorizați care integrează echipamentele OBU de la bordul vehiculelor de marfă cu platforma centrală.
3. Arhitectura tehnică (Conform Caietului de Sarcini al Licitației)
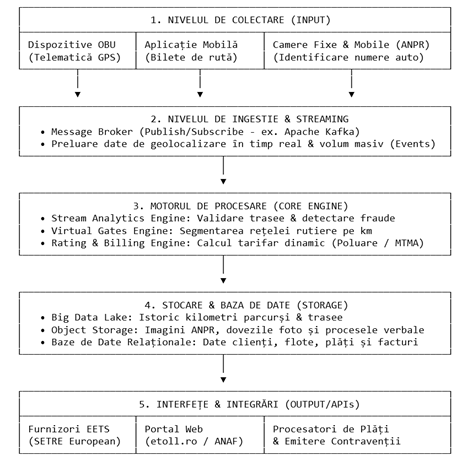
Sistemul a fost conceput ca o arhitectură distribuită, orientată pe servicii și procesare de volume mari de date (Big Data & Real-time Streaming). Principalele componente de arhitectură ale Lotului 1 includ:
- Sistemul de Containerizare și Microservicii:
- Utilizează containere izolate (de tip Docker/Kubernetes) pentru a permite scalarea automată a modulelor în perioadele cu trafic masiv pe servere.
- Componenta Big Data & Streaming Engine:
- Streaming Engine (Message Broker): Un sistem bazat pe modelul Publish/Subscribe (de tip Apache Kafka) care preia în timp real sute de mii de mesaje și poziții GPS transmise de dispozitivele din camioane sau de aplicația mobilă.
- Componenta Big Data: Stochează istoricul uriaș de date geolocalizate ale traseelor parcurse.
- Motorul de Procesare în Timp Real (Stream Analytics Engine):
- Analizează fluxul de date în timp real pentru a valida consistența călătoriilor și pentru a detecta anomalii sau fraude (de exemplu: raportarea simultană a aceluiași număr de înmatriculare în două puncte geografice incompatibile).
- Sistemul Central (Core System):
- Porți Virtuale (Virtual Gates): Segmentarea virtuală a rețelei rutiere naționale pentru calculul automat al kilometrilor parcurși de un vehicul la trecerea dintr-un sector în altul.
- Algoritm de calcul al tarifelor: Calcularea dinamică a prețului în funcție de masa totală (MTMA), numărul de axe, clasa de poluare EURO și tipul de drum (autostradă, drum expres, drum național).
- Gestiune clienți și flote: Administrarea conturilor de persoane fizice și juridice, interfațate prin portalul web etoll.ro.
- Modulul de Colectare și Procesare a Contravențiilor:
- Integrează camerele fixe ANPR (recunoașterea automată a numerelor de înmatriculare) și punctele de control mobile.
- Stochează imaginile și dovezile în baze de date de tip Object Storage și generează automat procesele-verbale de constatare a amenzilor.
- Interfețe API de Integrare:
- Servicii dedicate conectării cu infrastructurile operatorilor europeni SETRE și cu procesatorii de plăți bancare.
Referințe
CNAIR / AGERPRES, „Situația platformei TollRo: ce s-a remediat și ce urmează”, 1 octombrie 2026 – date privind primele 12 ore de funcționare, măsurile de stabilizare și reconcilierea tranzacțiilor.
HotNews, „Atenție! Incident tehnic. Noul sistem de taxare rutieră TollRo, lansat astăzi, nu funcționează”, 1 octombrie 2026 – comunicarea CNAIR referitoare la e-mailuri, throttling și fluxurile de plată.
AGERPRES, „CNAIR solicită amânarea aplicării TollRo până la 1 aprilie 2027”, 18 septembrie 2026 – pilotarea începută la 16 septembrie, durata contractuală minimă și stadiul recepției calitative.
HotNews, „Anunțul CNAIR pentru șoferi cu câteva ore înainte de intrarea în vigoare a sistemului TollRo”, 30 septembrie 2026 – trecerea din pilot în producție fără migrarea conturilor și a datelor introduse anterior.
Google Site Reliability Engineering, „Launch Coordination Checklist” și „Reliable Product Launches at Scale” – capacity planning, launch spikes, dependențe externe, load testing, rate limiting, rollout gradual și pregătirea serviciilor pentru producție.
AWS Well-Architected Framework, „Load test your workload” – testarea end-to-end și testarea la sarcini care depășesc nivelul anticipat.
Microsoft Azure Architecture Center, „Circuit Breaker Pattern”, „Retry Pattern” și recomandările privind gestionarea erorilor tranzitorii – circuit breakers, retry, backoff, retry budgets și idempotency.
Google Gmail, „Email sender guidelines” – creșterea graduală a volumului, evitarea spike-urilor și mecanismele de rate limiting.

